

2026-09-18
RTX 5090价格飙涨至9000美元,AI买家囤货照片疑为AI生成
RTX 5090最低售价已从1999美元涨至逾6000美元,部分渠道报价超9000美元,据称与AI服务器厂商囤货有关,但相关照片被指可能为AI生成,真实性存疑。

RTX 5090最低售价已从1999美元涨至逾6000美元,部分渠道报价超9000美元,据称与AI服务器厂商囤货有关,但相关照片被指可能为AI生成,真实性存疑。

NVIDIA介绍多智能体工作流:借助Omniverse Libraries和OpenUSD,将Blender场景自动转化为可用于Isaac Sim/Isaac Lab的仿真就绪世界。

NVIDIA团队开发AI智能体技能,将TileGym中24个cuTile Python/Triton-TileIR内核自动转译为cuTile Rust,性能达原版99.5%,token成本降低约一半。

NVIDIA TensorRT Edge-LLM运行Qwen3.6-27B在MLPerf Edge Agentic基准测试中,于单个Jetson AGX Thor上以24分36秒完成全部1007轮测试,较llama.cp...

费城儿童医院利用NVIDIA开源AI工具,可在数秒内建立儿童心脏三维模型,帮助医生为先天性心脏病患儿定制更精准的手术方案。

NVIDIA推出Groq 3 LPX加速器,通过确定性执行与PEP、CPS技术减少电压裕量,配合Vera Rubin NVL72平台提升每兆瓦token吞吐量,最高较GB200 NVL72提升35倍。

文章解析Dense与MoE两种模型架构差异,以Nemotron 3.5 Lightning为例说明MoE如何用3B激活参数实现30B模型容量,并给出内存、并发、微调等场景选型建议。

Perplexity推出Portable Computer的Windows版本,基于NVIDIA RTX GPU本地运行AI智能体,支持敏感数据本地处理并可按需接入云端模型。
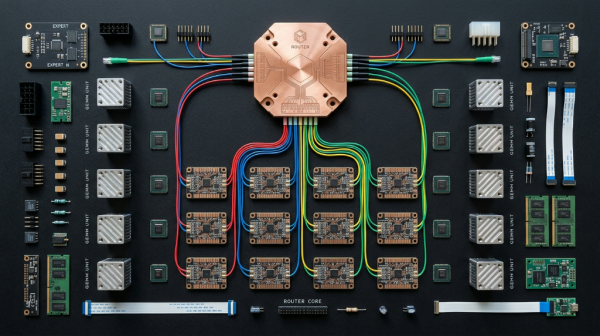
NVIDIA通过Transformer Engine对JAX中的Dropless MoE训练进行分组GEMM、专家并行等优化,使DeepSeek-V3训练性能从103提升至1068 TFLOPS/GPU,1024 GPU...

英伟达宣布以130亿美元收购Hugging Face,双方承诺平台保持开放中立,但分析师提醒企业需警惕长期治理与生态集中风险。

NVIDIA通过NIM 2.0.12全栈优化,在4xB200硬件上为Nemotron 3 Ultra智能体工作负载实现最高2.5倍并发用户吞吐量提升,优化涵盖内核、并行、前缀缓存与推测解码等技术。

Skild AI基于NVIDIA物理AI基础设施推出S1机器人基础模型,可通过单段视频演示学习未见过的长周期任务,无需重新训练。测试中新任务成功率达66%,是同类系统的7倍以上,公司年营收已达1亿美元。

NVIDIA BioNeMo Inference Runtime通过内核优化、CUDA Graphs和Ray多GPU并行提升结构预测吞吐量,在千目标基准测试中较开源Boltz-2实现2.9倍吞吐提升并显著降低能耗。

英伟达宣布以129亿美元收购开源AI公司Hugging Face,承诺保持其硬件与模型中立。分析人士认为此举将影响企业AI模型的选型与部署。

NVIDIA发布CUDA Toolkit 13.4,新增Windows on Arm支持、Rubin架构预览、MPS V3及CCCL 3.4等多项GPU开发与性能优化功能。

NVIDIA介绍Dynamo框架的Encode-Prefill-Decode解耦技术,在图像密集、短中等输出及量化MoE模型场景下可将首token延迟降低最高5倍,端到端响应提速最高7倍。

NVIDIA发布CUDA Rust,提供cuda-oxide(SIMT)与cutile-rs(Tile)两条技术路线,支持原生Rust编写GPU内核并编译至PTX,两项目均处早期阶段。

NVIDIA推出PAIR虚拟推理路由器,可将本地网络中多台设备的算力聚合调用,缓解多智能体并发推理瓶颈。无需修改现有Agent框架,兼容Ollama和LM Studio,支持RTX GPU、DGX Spark及苹果M4+...

本文介绍如何在NVIDIA Jetson边缘设备上部署Nemotron 3.5 Lightning、Qwen3.8-27B等新一代紧凑型推理模型。通过NVFP4量化与推测解码等技术优化推理性能,可实现无需数据中心支持的本...

本文介绍团队使用NVIDIA NemoClaw构建的记忆驱动型"首席助理"智能体,通过维护结构化自我模型分离证据、知识与执行判断,实现跨时间上下文关联、用户意图优先排序及可纠错的反馈机制,并借助NVIDIA OpenSh...