
2026-10-14


2026-10-14
当好学生跟对好老师,为什么会学出问题?
论文发现,给弱模型优化过的工作流程(harness)虽然能让强模型用得更好,但直接让弱模型模仿强模型的操作记录做微调,成绩反而全面下滑,原因是打乱了模型与harness适配的规划节奏,论文提出在线纠正方案解决此矛盾。
2026-10-14
AI改代码时,到底该让它一次性重写整个文件,还是像人类程序员一样一小段一小段地打补丁?
本文解读了一项对比AI代码编辑两种方式的实证研究:直接重写整个文件与分步打补丁。作者训练四个模型对比发现,直接生成在编译通过率、相似度和AI评分上全面胜出,而打补丁模式仅在改动范围小的短任务中具备优势。
2026-10-14
让VLM直接开机械臂:新加坡团队发现,机器人操控真正缺的不是更大的模型
新加坡国立大学团队提出Show-Harness,通过紧凑的语义动作接口让视觉语言模型直接操控机械臂,既支持闭源大模型零样本部署,也支持小模型低成本微调,在多项真机泛化测试中显著超越主流VLA与智能体方案。

2026-10-14
去掉人类棋谱之后两天反超:David Silver要把这场赌注押到超级智能上
David Silver和Lasse Espeholt创立ineffable Intelligence,押注抛开人类数据与语言、仅靠经验学习通向超级智能,并讲述了离开DeepMind的理由、公司命名的双重含义,以及对“超...

2026-10-14
叠数千片餐巾不是终点:Dyna用预判未来的世界模型让机器人真正规模化部署
Dyna Robotics首席科学家Jason Ma讲述世界动作模型Dyna-2如何预测未来指导机器人动作,机器人如何靠45分钟演示学会新任务,以及机器人行业缺少数据"互联网"的真实瓶颈。

2026-10-14
Paul Graham:AI 的进化台阶走反了,一上来就是个满嘴空话的本科生
Paul Graham 复盘了他对 AI 最深的一次误判:当年以为会从一只完美的苍蝇逐级进化成一个完美的人,结果第一个 ChatGPT 是个满嘴空话、硬把论文糊过去的本科生。他解释了为什么被优化的维度是"像人"而不是"对...
2026-10-14
TI 将 Zephyr RTOS 支持扩展至其广泛的嵌入式产品组合
2026-10-14
思科报告:企业自身或成为网络安全团队面临的最大挑战
《持续防御报告》(Relentless Defense Report)聚焦网络安全从业者如何应对正被AI重塑的威胁格局。该报告评估企业保护自身环境的全面程度、检测、响应和修复威胁的速度,以及影响企业采取行动的因素。

2026-10-14
探索数字主权的三大维度:数据主权、运营主权与技术主权
Gartner指出,数字主权主要由数据主权、运营主权、技术主权三层构成。基础设施与运营(I&O)领导者必须理解数字主权频谱,制定全面的数字主权战略,以明确和制定适合的解决方案并管理相关风险。
2026-10-14
三个月落地 10 只基金备案,GIM Capital 迈入产品化运行阶段
2026-10-14
当游戏世界会自己"忘事儿"的时候,你该怎么办?
论文提出可编程世界模型,把视频世界的状态演化和画面渲染拆开,用3D定向包围盒连接引擎与生成模型,在CombatStateBench上实现94%计数准确率和98%状态准确率,大幅超越现有交互式视频模型。
2026-10-14
训练AI学推理,删掉一半"思考过程"反而更聪明
研究发现训练大语言模型时,删除推理轨迹中间20%冗余内容、仅保留首尾部分的E-SFT方法,比使用完整推理轨迹效果更好,该规律在SFT、强化学习GRPO和在线蒸馏中均成立。
2026-10-14
Φ-Bench:能写代码的AI,能不能把自己家的电线管好?
Φ-Bench是首个评测大语言模型能否自主开发和优化大模型基础设施的开放式基准,含85道分级任务,测试显示最强模型仅得36.53分,暴露当前AI在长周期系统工程上的明显短板。

2026-10-14
应用材料公司在硅谷揭幕投资50亿美元建设的EPIC中心,加速AI时代半导体创新
50亿美元投资打造全球规模最大的半导体设备与工艺技术研发设施之一 旨在加速下一代芯片制造技术从突破性创新迈向大规模量产 多家领先芯片制造商、系统公司、设备合作伙伴和研究型高校已承诺在EPIC中心开展研发
2026-10-14
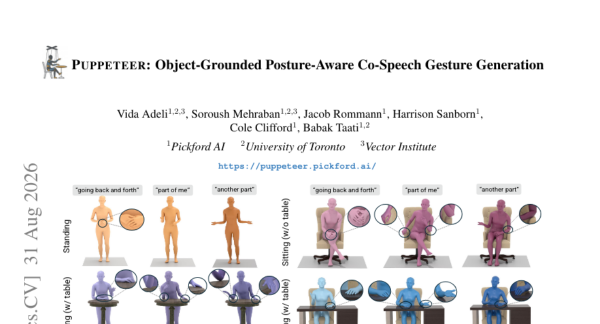
PUPPETEER:会看场合的AI手势生成,让虚拟人懂得坐姿站姿和身边的桌椅
本文解读PUPPETEER模型:一种能感知坐姿站姿和周围桌椅家具的AI配音手势生成系统,采用因果隐空间扩散架构实现精准语音对齐,并配套推出SCENEGES合成数据集,解决了以往手势生成模型忽视身体姿态和场景物体导致穿模的...

2026-10-14
AI智能体的工具箱一直在长大,但没人问过它记不记得旧本事
论文提出EvoHarnessBench基准,首次系统评估AI智能体在工具、技能、协作智能体持续扩容的harness环境下的表现,揭示了harness诱导遗忘和自我进化适应不稳定两大问题,为构建能跟上能力演化的智能体提供了...
2026-10-14
给4096个词打4个补丁,也能训好一个大模型?
本文解读Graph Machine架构:用整数边索引和浮点边权重取代密集注意力,仅检索4096词中2至4个位置,训练6亿参数模型损失不降反升,计算量还降低近两成。