

2026-09-28
让AI自己写TPU芯片的代码,谷歌这次玩明白了
谷歌团队推出MaxKernel,一套用大语言模型配合真实编译反馈自动生成TPU硬件内核的多智能体系统。它支持人机协作、全自动优化、图搜索三种模式,在JaxBench基准上实现1.58倍加速,部分任务甚至超越人类专家手工调...

谷歌团队推出MaxKernel,一套用大语言模型配合真实编译反馈自动生成TPU硬件内核的多智能体系统。它支持人机协作、全自动优化、图搜索三种模式,在JaxBench基准上实现1.58倍加速,部分任务甚至超越人类专家手工调...

大模型修bug时常把代码改得面目全非。研究者用400道注入bug的编程题构建评测框架,发现顶级模型普遍存在过度编辑现象,提示词能显著缓解,强化学习则能让模型学会更持久的克制编辑习惯。

RISE是一种让大模型用自身强化学习训练轨迹外推出"未来教师",再逐字蒸馏回当前模型的训练方法。无需外部模型或答案提示,在数学、理科、代码、智能体任务上全面超越RLVR训练和已有自蒸馏方法,且额外计算开销仅1.3到1.6...

从Alpaca的600美元实验到日均10万亿token的推理网关,OpenRouter联合创始人Alex Atallah与a16z合伙人Anjney Midha回顾了开源模型崛起、Discord早期AI部署、以及toke...

9月28日消息,千问App与夸克网盘深度打通,用户授权后,可在千问中查询、整理和读取网盘资料,并据此生成复习工具、工作总结、照片合集。

Cerebras团队通过2400余次实验证明,配置得当的层级Dropout能让大模型训练节省最高25%算力且精度不降,还能解锁早退、层跳跃、自投机解码等推理加速技术,最高提速1.5倍。
Testin云测XAgent智能测试系统,正是该范式下成熟的工程化落地实践。整套平台以“AI智测大脑+软件测试机器人”作为核心架构,融合大语言模型LLM、视觉多模态模型VLM、Multi-Agent多智能体集群、RAG检...
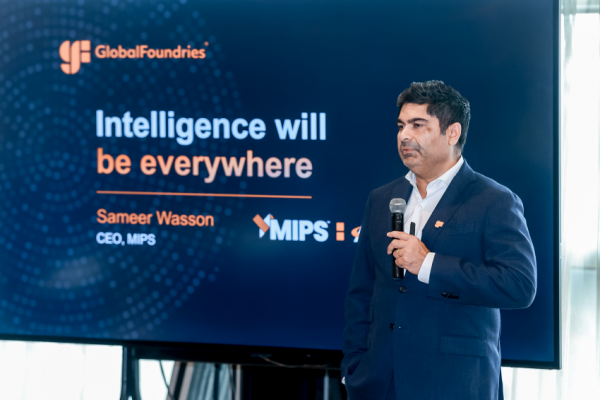
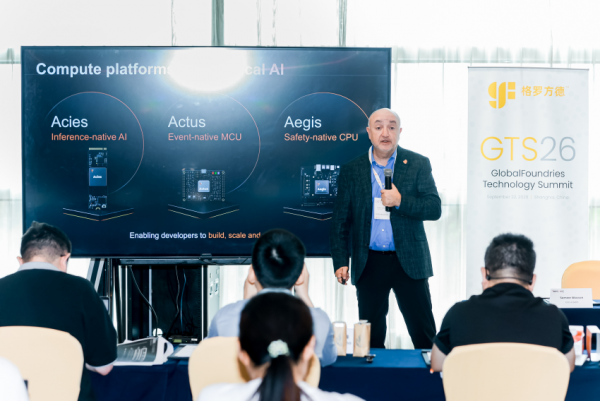
MIPS发布了Acies、Actus、Aegis三款“工作负载原生”平台,并将每瓦Token数(tokens-per-watt)作为衡量能效的核心指标。
“技术不能只服务于‘出报告’,更要服务于一线,支撑本质安全。”近日在2026全球工业互联网大会举办期间,中建材信息技术股份有限公司(以下简称中建材信息)副总经理王乔晨在接受专访时表示。

2014年,深度学习在视频动作识别上被手工特征甩开近20个百分点。牛津大学团队提出双流网络,把视频拆成空间流和时间流分别处理再融合,准确率达88%,首次实现反超,成为视频理解领域的里程碑工作。

这篇论文发现强化学习训练模型时,固定的裁剪阈值会误伤稀缺却珍贵的正确答案。作者提出GAPO方法,让裁剪区间根据答案优势值动态调整,在多个模型和数学编程任务上稳定提升了准确率与多样性。

Ricursive Intelligence联合创始人Anna Goldie与Azalia Mirhoseini将出席TechCrunch Disrupt 2026,探讨AI自主设计芯片的前景。该公司已融资3.35亿美元...